Den 14 september 2026 släppte vi Klang Dialects, ett öppet dataset och testunderlag för svensk taligenkänning. Inspelningarna samlades in genom Knäck Klang, där deltagare läste tre meningar med sin egen dialekt. Ju svårare Klang hade att transkribera talet, desto fler poäng fick deltagaren.
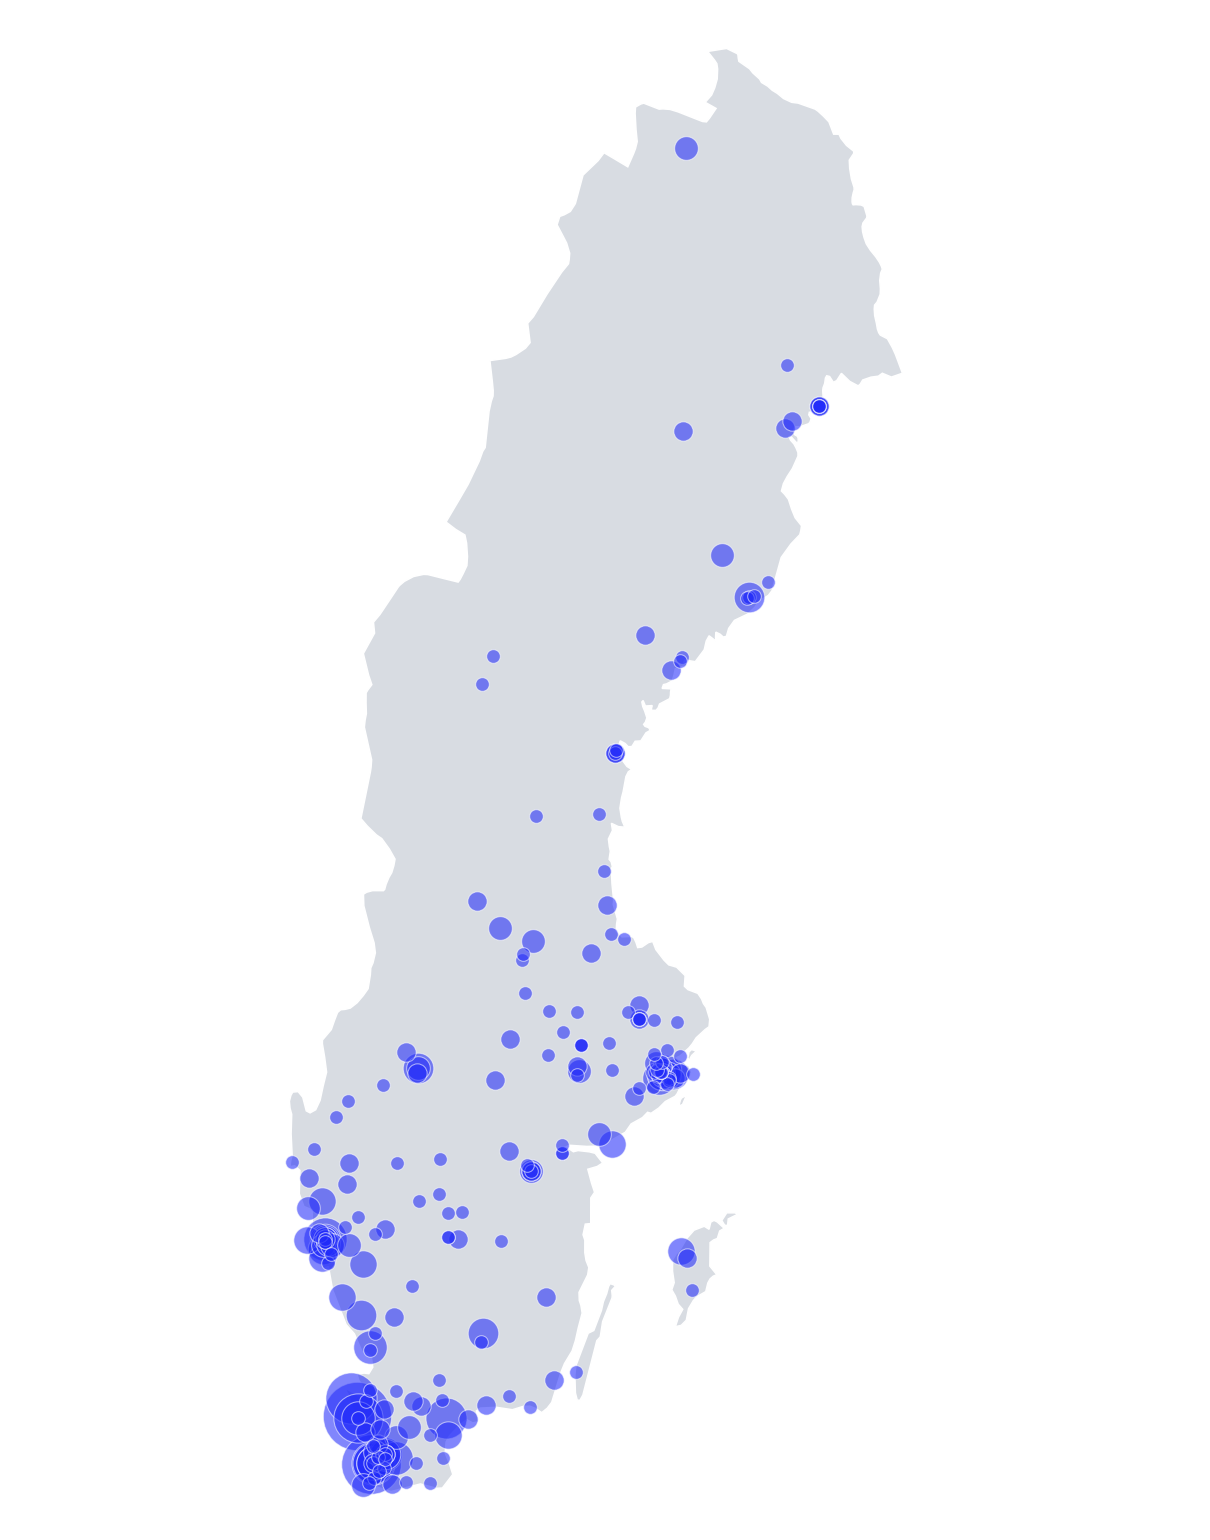
Svenska dialekter är underrepresenterade i vanliga testunderlag för taligenkänning. Klang Dialects ger forskare och utvecklare möjlighet att undersöka hur tekniken fungerar för fler sätt att tala svenska. Bidragen kommer från olika delar av landet, med flest inspelningar från södra Sverige.
Versionen sv-clean innehåller 1 804 inspelningar med kvalitetssäkrade referenstexter. Vårt forskningsteam granskade omkring 1 000 inspelningar manuellt för att säkerställa att texten motsvarar det som faktiskt sägs. Datasetet finns fritt tillgängligt på Hugging Face, tillsammans med en beskrivning av hur det kan användas.
Hämta datasetet på Hugging Face